

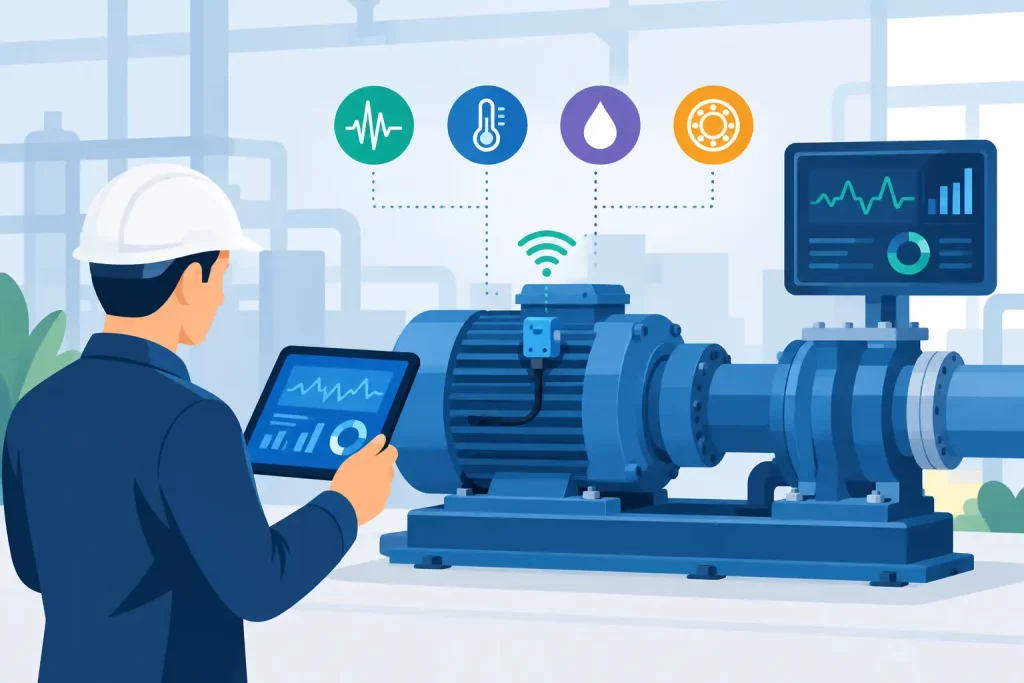
Um rolamento raramente falha sem deixar primeiro sinais. O seu espectro de vibração altera-se, o perfil acústico muda, a temperatura pode subir e a assinatura da corrente do motor pode tornar-se menos estável. O valor prático de um guia de monitorização da condição de máquinas está em transformar estes sinais fracos e iniciais numa decisão de manutenção acionável antes de ocorrer uma interrupção da produção, danos no equipamento ou um incidente de segurança.
A monitorização da condição não é apenas um sensor ou um painel. É um sistema de medição e reconhecimento concebido de forma integrada: adquirir o sinal correto, preservar as características que indicam degradação, classificar estados operacionais normais e anómalos e fornecer uma decisão com rapidez suficiente para influenciar as operações. A arquitetura também precisa de funcionar sob restrições da fábrica, como ruído elétrico, conectividade intermitente, espaço limitado em armários, sistemas de controlo antigos e cargas variáveis.
O que a monitorização da condição de máquinas deve detetar
O objetivo não é simplesmente recolher mais dados da máquina. É distinguir uma alteração significativa da condição de uma variação normal causada pelo mix de produtos, velocidade, carga, condições ambientais ou comportamento do operador. Um sistema útil identifica o estado de um ativo, estima se esse estado está a mudar e comunica o nível de intervenção necessário.
Para equipamentos rotativos, os alvos comuns incluem desequilíbrio, desalinhamento, folgas, defeitos em rolamentos, danos no engrenamento, problemas de lubrificação, cavitação, desgaste de correias e falhas elétricas. Em equipamentos de processo, o alvo pode ser aderência de válvulas, instabilidade de bombas, surge de compressores, fluxo bloqueado, combustão anómala ou degradação de atuadores. Os modos de falha definem o método de deteção, o conjunto de características, a taxa de amostragem e a lógica de alarmes.
O desenho da monitorização deve começar por uma análise dos modos de falha. Uma tendência de vibração de baixa frequência pode revelar folgas estruturais, enquanto danos iniciais em rolamentos frequentemente exigem dados de aceleração de frequência mais elevada ou medição acústica. A análise da corrente do motor pode revelar alterações elétricas e relacionadas com a carga sem instalar um sensor diretamente no componente acionado. A deteção térmica é útil para fricção e pontos quentes elétricos, mas normalmente é um indicador mais lento do que vibração ou acústica.
Nenhuma modalidade é universalmente suficiente. Uma bomba centrífuga numa linha de processo de velocidade variável pode beneficiar de vibração, pressão de sucção e descarga, corrente do motor e velocidade de operação. Uma caixa de velocidades pode exigir aceleração de elevada largura de banda, referência de tacómetro e dados de partículas no óleo. O conjunto correto de sensores depende da física da falha e do acesso disponível na máquina.
Guia de monitorização da condição de máquinas: construa a partir do ativo
Comece por separar os ativos de acordo com a criticidade. Um ventilador de baixo custo com redundância instalada pode ser monitorizado com medições periódicas simples. Um compressor de alta velocidade que limita toda uma linha de produção exige deteção contínua, análise imediata e um percurso de resposta definido. A criticidade determina a quantidade de sensores, capacidade computacional, esforço de validação e redundância do sistema que se justificam.
Depois, estabeleça uma linha de base em condições operacionais representativas. É aqui que muitos projetos falham. Um modelo treinado apenas quando uma máquina funciona a uma velocidade ou produz um único produto irá assinalar alterações legítimas da produção como anomalias. Recolha dados durante arranques normais, paragens, operação em regime estável, gamas esperadas de carga e transições conhecidas do processo. Registe ações de manutenção e falhas confirmadas sempre que possível. Esses registos criam o ground truth necessário para avaliar a qualidade da deteção.
Os dados de referência devem incluir tanto sinais brutos como contexto da máquina. Por exemplo, medições de vibração sem velocidade do veio, carga e estado do processo podem ser enganadoras. Um aumento da amplitude de vibração pode ser um defeito real ou apenas um efeito normal do aumento de velocidade. Os canais de contexto permitem às ferramentas analíticas comparar condições equivalentes.
A qualidade da instalação do sensor é tão importante quanto a escolha do sensor. Acelerómetros montados com ímanes soltos ou em proteções finas e ressonantes podem gerar dados que refletem a montagem em vez da máquina. A montagem permanente por perno normalmente proporciona melhor resposta a altas frequências do que a montagem temporária, embora nem sempre seja prática. O encaminhamento dos cabos, ligação à terra, proteção contra entrada de contaminantes, gama de temperatura, procedimentos de calibração e seleção de conectores afetam a fiabilidade dos dados em instalações industriais.
Escolha a amostragem e as características em função da falha
Uma amostragem demasiado lenta elimina conteúdo de diagnóstico. No entanto, recolher tudo com resolução máxima aumenta o armazenamento, tráfego de rede e custo de processamento sem necessariamente melhorar as decisões de manutenção. A frequência-alvo da falha e o método de análise pretendido devem determinar a estratégia de aquisição.
Características no domínio do tempo, como RMS, pico, fator de crista, curtose e inclinação da tendência, são eficazes em muitas aplicações de triagem. A análise no domínio da frequência identifica conteúdo harmónico, frequências relacionadas com rolamentos, componentes de engrenamento e bandas laterais. A análise de envelope pode aumentar a sensibilidade a impactos repetitivos causados por defeitos em rolamentos de elementos rolantes. O order tracking é valioso quando a velocidade de rotação varia. Para acústica, assinaturas espectrais e eventos transitórios podem identificar fugas, impactos, fricção ou operação instável.
A engenharia de características continua a ser útil, mas não é o único caminho. O reconhecimento de padrões treinável pode classificar formas complexas de sinais diretamente a partir de janelas selecionadas, espectros, imagens ou características combinadas de sensores. Isto é particularmente valioso quando um limiar convencional não consegue separar uma variação normal do processo de uma alteração real da condição.
Decida onde o reconhecimento é executado
A análise cloud pode suportar comparação de toda a frota, armazenamento a longo prazo e relatórios centralizados. É menos adequada quando as decisões precisam de ser tomadas em milissegundos, a conectividade é limitada, a transferência de sinais brutos é dispendiosa ou os dados operacionais não podem sair das instalações. Muitos sistemas industriais utilizam, por isso, uma arquitetura em camadas: aquisição e reconhecimento inicial no edge, visualização de supervisão num servidor local ou rede de controlo e agregação opcional de nível superior noutro local.
O reconhecimento no edge reduz a latência e evita que fluxos contínuos de vibração ou áudio de alta frequência saturem a rede. Também permite que uma máquina continue monitorizada durante uma falha de rede. Para ações próximas da segurança ou críticas para a produção, o dispositivo edge deve fornecer interfaces determinísticas para alarmes, PLCs, variadores ou sistemas de supervisão, preservando simultaneamente os dados do evento para análise posterior pela engenharia.
A NeuroTechnologijos aplica controladores neurais treináveis a este tipo de requisito, suportando reconhecimento embebido de vibração, áudio, vídeo e outros sinais industriais não estruturados. A escolha do hardware continua a depender da instalação. Um formato PCIe pode ser adequado para um computador industrial ou servidor, enquanto um controlador embebido ou formato baseado em Raspberry Pi pode adaptar-se a um nó de deteção distribuído. A seleção deve seguir os canais necessários, largura de banda do sinal, condições ambientais, requisitos de interface e acesso para manutenção — e não a preferência por uma determinada plataforma computacional.
Utilize modelos e limiares em conjunto
Os limiares são transparentes e fáceis de validar. Funcionam bem quando uma variável conhecida possui um limite operacional claro, como temperatura do rolamento, severidade geral da vibração ou diferencial de pressão. A sua fraqueza é que limites fixos não se adaptam bem a alterações de velocidade, carga ou condições de produto.
A deteção de anomalias e os classificadores treináveis podem reconhecer padrões que excedem regras simples. Exigem dados de treino disciplinados e validação contínua. Um modelo que detete todos os padrões incomuns pode gerar demasiados alarmes se não tiver em conta o estado operacional. Um modelo treinado apenas com operação normal pode identificar um desvio, mas não o tipo de falha. Um modelo supervisionado pode distinguir classes de falhas, mas precisa de exemplos rotulados que podem ser difíceis de obter.
As implementações mais eficazes combinam frequentemente vários métodos. Utilize limites determinísticos para proteção imediata do equipamento, tendências da condição para planeamento da manutenção e reconhecimento de padrões para assinaturas iniciais ou ambíguas. Cada alerta deve indicar a evidência medida, confiança ou gravidade, contexto operacional da máquina e a próxima ação recomendada.
Desenhe o fluxo de alarmes antes da implementação
Um alarme sem responsável é apenas uma notificação. Antes do comissionamento, defina quem recebe cada alerta, que inspeção é esperada, como os resultados são registados e quando o modelo ou limiar deve ser ajustado. As equipas de manutenção precisam de evidência utilizável: uma alteração do espectro, excerto da forma de onda, histórico de tendência, comparação com a linha de base ou padrão de condição identificado. Não precisam de uma pontuação sem explicação.
A estratégia de alarmes deve incluir pelo menos estados de aviso, ação e crítico. Alertas de aviso podem desencadear observação reforçada. Alertas de ação devem criar uma inspeção planeada ou ordem de trabalho. Alertas críticos podem exigir uma alteração imediata da operação, paragem controlada ou escalonamento para engenharia. A resposta deve refletir a criticidade do ativo e a confiança da deteção.
Falsos positivos reduzem a confiança, mas suprimir alertas de forma demasiado agressiva pode ocultar falhas iniciais. Acompanhe precisão, deteções falhadas, frequência de alertas, tempo entre alerta e confirmação do problema e tempo de paragem evitado, quando existirem registos. Reveja estas métricas depois de alterações nas máquinas, materiais, horários de produção ou práticas de manutenção. A monitorização da condição é um sistema de engenharia que precisa de manutenção contínua, não uma instalação única.
Integre com os sistemas industriais existentes
Um nó de monitorização deve coexistir com a arquitetura da fábrica. Confirme a alimentação disponível, conectividade Ethernet ou fieldbus, limitações do armário, sincronização temporal, política de cibersegurança e requisitos de retenção de dados antes de selecionar o hardware. Verifique como o sistema irá trocar estados com PLCs, SCADA, historians, software de manutenção e interfaces de operador.
A interoperabilidade deve ser especificada desde cedo. Decida se o sistema de monitorização publica alarmes discretos, valores analógicos, vetores de características, ficheiros de eventos ou todos estes tipos de dados. Utilize eventos com marca temporal e mantenha histórico suficiente do sinal antes e depois do trigger para suportar o diagnóstico. Se um controlador iniciar uma resposta automatizada, documente o estado fail-safe e garanta que a ação pode ser testada sem expor pessoas ou equipamento a riscos desnecessários.
O comissionamento deve incluir condições deliberadamente introduzidas ou simuladas sempre que viável, juntamente com comparação com medições portáteis e inspeção especializada. O objetivo não é provar que o sistema consegue apresentar dados. É provar que deteta uma alteração relevante, a comunica corretamente e conduz a uma resposta adequada.
O melhor sistema de monitorização é aquele que fornece às equipas de manutenção aviso suficiente para agir enquanto o equipamento ainda está sob controlo. Comece pelos modos de falha mais importantes, preserve o detalhe do sinal necessário para os reconhecer e torne cada alerta rastreável até evidência que um técnico possa verificar.
