

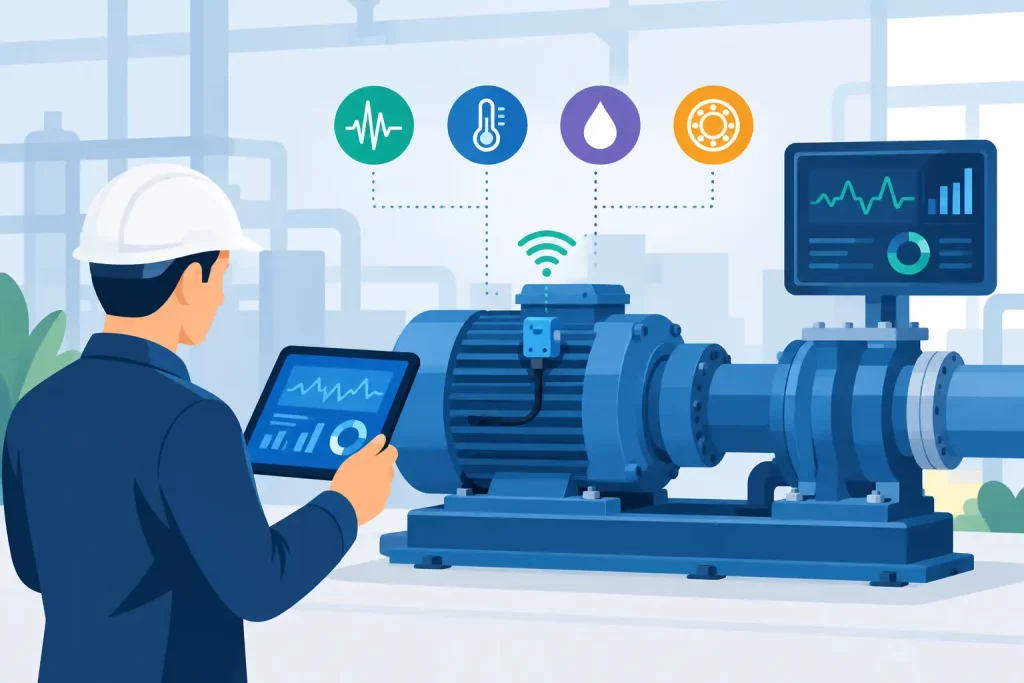
Un rodamiento rara vez falla sin dejar antes señales. Su espectro de vibración cambia, el perfil acústico se modifica, la temperatura puede aumentar y la firma de corriente del motor puede volverse menos estable. El valor práctico de una guía de monitorización del estado de máquinas consiste en convertir esas señales débiles y tempranas en una decisión de mantenimiento accionable antes de que se produzca una interrupción de producción, daños en el equipo o un incidente de seguridad.
La monitorización de condición no es un único sensor ni un panel. Es un sistema de medición y reconocimiento diseñado de forma integrada: adquirir la señal adecuada, conservar las características que indican degradación, clasificar estados operativos normales y anómalos y entregar una decisión con suficiente rapidez como para afectar a las operaciones. La arquitectura también debe funcionar bajo restricciones reales de planta, como ruido eléctrico, conectividad intermitente, espacio limitado en armarios, controles antiguos y cargas variables.
Qué debe detectar la monitorización del estado de máquinas
El objetivo no consiste simplemente en recopilar más datos de la máquina. Consiste en distinguir un cambio significativo de condición de la variación normal causada por la mezcla de productos, la velocidad, la carga, las condiciones ambientales o el comportamiento del operador. Un sistema útil identifica el estado de un activo, estima si ese estado está cambiando y comunica el nivel de intervención requerido.
En equipos rotativos, los objetivos habituales incluyen desequilibrio, desalineación, holgura, defectos de rodamientos, daños en engranajes, problemas de lubricación, cavitación, desgaste de correas y fallos eléctricos. En equipos de proceso, el objetivo puede ser fricción o agarrotamiento de válvulas, inestabilidad de bombas, surge de compresores, flujo bloqueado, combustión anómala o degradación de actuadores. Los modos de fallo definen el método de sensorización, el conjunto de características, la frecuencia de muestreo y la lógica de alarmas.
El diseño de monitorización debe comenzar con una revisión de los modos de fallo. Una tendencia de vibración de baja frecuencia puede revelar holgura estructural, mientras que los daños tempranos en rodamientos suelen requerir datos de aceleración de mayor frecuencia o medición acústica. El análisis de corriente del motor puede exponer cambios eléctricos y relacionados con la carga sin instalar un sensor directamente sobre el componente accionado. La sensorización térmica resulta útil para fricción y puntos calientes eléctricos, aunque normalmente es un indicador más lento que la vibración o la acústica.
Ninguna modalidad es universalmente suficiente. Una bomba centrífuga en una línea de proceso de velocidad variable puede beneficiarse de vibración, presión de aspiración y descarga, corriente del motor y velocidad de funcionamiento. Una caja de engranajes puede requerir aceleración de gran ancho de banda, referencia de tacómetro y datos de partículas en el aceite. El conjunto adecuado de sensores depende de la física del fallo y del acceso disponible en la máquina.
Guía de monitorización del estado de máquinas: construya desde el activo hacia afuera
Empiece separando los activos según su criticidad. Un ventilador de bajo coste con redundancia instalada puede monitorizarse mediante mediciones periódicas sencillas. Un compresor de alta velocidad que limita toda una línea de producción requiere sensorización continua, análisis inmediato y una ruta de respuesta definida. La criticidad determina cuánto sensado, capacidad de cálculo, esfuerzo de validación y redundancia del sistema están justificados.
A continuación, establezca una referencia bajo condiciones operativas representativas. Aquí es donde fallan muchos proyectos. Un modelo entrenado únicamente cuando una máquina funciona a una velocidad o produce un solo producto marcará cambios legítimos de producción como anomalías. Capture datos durante arranques y paradas normales, operación estable, rangos esperados de carga y transiciones conocidas del proceso. Registre acciones de mantenimiento y fallos confirmados cuando sea posible. Esos registros crean el ground truth necesario para evaluar la calidad de detección.
Los datos de referencia deben incluir tanto señales brutas como contexto de la máquina. Por ejemplo, las mediciones de vibración sin velocidad del eje, carga y estado del proceso pueden ser engañosas. Un aumento de la amplitud de vibración puede ser un defecto real o un efecto normal del aumento de velocidad. Los canales de contexto permiten a los análisis comparar condiciones equivalentes.
La calidad de instalación del sensor es tan importante como su selección. Los acelerómetros montados con imanes flojos o sobre protecciones delgadas y resonantes pueden generar datos que reflejan el montaje en lugar de la máquina. El montaje permanente con espárrago suele proporcionar una mejor respuesta de alta frecuencia que un montaje temporal, aunque no siempre es práctico. El tendido de cables, la puesta a tierra, la protección contra entrada de contaminantes, el rango de temperatura, los procedimientos de calibración y la selección de conectores afectan a la fiabilidad de los datos en instalaciones industriales.
Seleccione el muestreo y las características según el fallo
Muestrear demasiado despacio elimina contenido diagnóstico. Sin embargo, registrar todo a máxima resolución aumenta el almacenamiento, el tráfico de red y el coste de procesamiento sin mejorar necesariamente las decisiones de mantenimiento. La frecuencia objetivo del fallo y el método de análisis deseado deben determinar la estrategia de adquisición.
Las características en el dominio temporal, como RMS, pico, factor de cresta, curtosis y pendiente de tendencia, son eficaces en muchas aplicaciones de cribado. El análisis en el dominio de la frecuencia identifica contenido armónico, frecuencias relacionadas con rodamientos, componentes de engrane y bandas laterales. El análisis de envolvente puede mejorar la sensibilidad a impactos repetitivos provocados por defectos en rodamientos de elementos rodantes. El order tracking resulta útil cuando cambia la velocidad de rotación. En acústica, las firmas espectrales y los eventos transitorios pueden identificar fugas, impactos, fricción u operación inestable.
La ingeniería de características sigue siendo útil, pero no es la única vía. El reconocimiento de patrones entrenable puede clasificar formas complejas de señales directamente a partir de ventanas seleccionadas, espectros, imágenes o características fusionadas de sensores. Esto resulta especialmente valioso cuando un umbral convencional no puede separar una variación normal del proceso de un cambio real de condición.
Decida dónde se ejecuta el reconocimiento
Los análisis cloud pueden respaldar comparación de flotas, almacenamiento a largo plazo e informes centralizados. Son menos adecuados cuando las decisiones deben tomarse en milisegundos, la conectividad es limitada, la transferencia de señales brutas resulta costosa o los datos operativos no pueden salir de las instalaciones. Por ello, muchos sistemas industriales utilizan una arquitectura por capas: adquisición y reconocimiento inicial en el edge, visualización de supervisión en un servidor local o red de control y agregación opcional de nivel superior en otro sistema.
El reconocimiento en el edge reduce la latencia y evita que flujos continuos de vibración o audio de alta frecuencia saturen la red. También permite que una máquina siga monitorizada durante una interrupción de red. Para acciones próximas a la seguridad o críticas para la producción, el dispositivo edge debería proporcionar interfaces deterministas con alarmas, PLC, variadores o sistemas de supervisión, conservando a la vez los datos del evento para una revisión posterior de ingeniería.
NeuroTechnologijos aplica controladores neuronales entrenables a este tipo de requisito, permitiendo reconocimiento embebido de vibración, audio, vídeo y otras señales industriales no estructuradas. La selección de hardware sigue dependiendo de la instalación. Un formato PCIe puede ser adecuado para un ordenador industrial o servidor, mientras que un controlador embebido o un formato basado en Raspberry Pi puede adaptarse a un nodo de sensorización distribuido. La selección debe basarse en los canales requeridos, el ancho de banda de señal, las condiciones ambientales, las necesidades de interfaz y el acceso para mantenimiento, no en una preferencia por una plataforma informática concreta.
Utilice modelos y umbrales conjuntamente
Los umbrales son transparentes y fáciles de validar. Funcionan bien cuando una variable conocida tiene un límite operativo claro, como la temperatura del rodamiento, la severidad global de vibración o la presión diferencial. Su debilidad es que los límites fijos no se adaptan bien a cambios de velocidad, carga o condiciones de producto.
La detección de anomalías y los clasificadores entrenables pueden reconocer patrones que superan las reglas simples. Requieren datos de entrenamiento disciplinados y validación continua. Un modelo que detecta todos los patrones inusuales puede generar demasiadas alarmas salvo que esté condicionado por el estado operativo. Un modelo entrenado únicamente con operación normal puede identificar una desviación, pero no su tipo de fallo. Un modelo supervisado puede distinguir clases de fallos, pero necesita ejemplos etiquetados que pueden ser difíciles de obtener.
Los despliegues más eficaces suelen combinar métodos. Utilice límites deterministas para protección inmediata del equipo, tendencias de condición para planificación de mantenimiento y reconocimiento de patrones para firmas tempranas o ambiguas. Cada alerta debería indicar la evidencia medida, la confianza o gravedad, el contexto operativo de la máquina y la siguiente acción recomendada.
Diseñe el flujo de alarmas antes del despliegue
Una alarma sin responsable es solo una notificación. Antes de la puesta en marcha, defina quién recibe cada alerta, qué inspección se espera, cómo se registran los hallazgos y cuándo debe ajustarse el modelo o el umbral. Los equipos de mantenimiento necesitan evidencias utilizables: un cambio de espectro, un fragmento de forma de onda, historial de tendencia, comparación con la referencia o un patrón de condición identificado. No necesitan una puntuación sin explicación.
La estrategia de alarmas debería incluir al menos estados de aviso, acción y crítico. Las alertas de aviso pueden activar una observación más intensa. Las alertas de acción deberían generar una inspección planificada o una orden de trabajo. Las alertas críticas pueden exigir un cambio inmediato de operación, una parada controlada o una escalada a ingeniería. La respuesta debe reflejar la criticidad del activo y la confianza de la detección.
Los falsos positivos dañan la confianza, pero suprimir alarmas de forma demasiado agresiva puede ocultar fallos tempranos. Controle precision, detecciones perdidas, frecuencia de alertas, tiempo desde la alerta hasta la confirmación y tiempo de inactividad evitado cuando existan registros. Revise estas métricas tras cambios en maquinaria, materiales, horarios operativos o prácticas de mantenimiento. La monitorización de condición es un sistema de ingeniería que debe mantenerse, no una instalación puntual.
Integre con los sistemas industriales existentes
Un nodo de monitorización debe coexistir con la arquitectura de planta. Confirme la alimentación disponible, conectividad Ethernet o fieldbus, limitaciones de armario, sincronización temporal, política de ciberseguridad y requisitos de retención de datos antes de seleccionar hardware. Verifique cómo intercambiará el sistema estados con PLC, SCADA, historians, software de mantenimiento e interfaces de operador.
La interoperabilidad debe especificarse desde el principio. Decida si el sistema de monitorización publicará alarmas discretas, valores analógicos, vectores de características, archivos de eventos o todos ellos. Utilice eventos con marca temporal y conserve suficiente historial de señal anterior y posterior al trigger para apoyar el diagnóstico. Si un controlador inicia una respuesta automatizada, documente el estado fail-safe y asegúrese de que la acción pueda probarse sin exponer a personas o equipos a riesgos innecesarios.
La puesta en marcha debería incluir condiciones introducidas deliberadamente o simuladas cuando sea viable, además de comparaciones con mediciones portátiles e inspección experta. El objetivo no es demostrar que el sistema puede mostrar datos. Es demostrar que detecta un cambio relevante, lo comunica correctamente y conduce a una respuesta apropiada.
El mejor sistema de monitorización es aquel que proporciona a los equipos de mantenimiento suficiente aviso para actuar mientras el equipo todavía está bajo control. Empiece por los modos de fallo que más importan, conserve el detalle de señal necesario para reconocerlos y haga que cada alerta sea trazable hasta evidencias que un técnico pueda verificar.
