

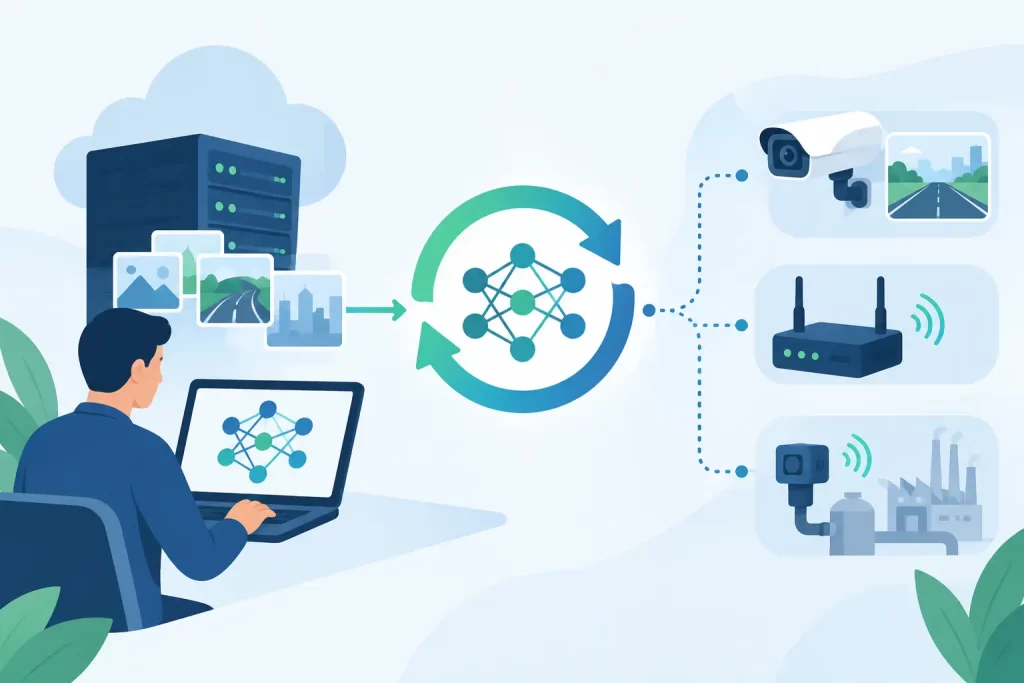
Модель, успешно прошедшая приёмочные испытания, со временем всё равно может стать самым слабым компонентом системы промышленной автоматизации. Изменения освещения, крепления датчиков, износ оборудования, новые партии материалов, акустический фон или рабочие рецептуры меняют распределение сигналов, поступающих на периферию. Лучшие практики переобучения моделей начинаются с того, что такие изменения рассматриваются как контролируемые инженерные события, а не как случайная реакция на падение точности.
Для промышленного ИИ переобучение — это не просто задача data science. Оно влияет на пороги распознавания, поведение контроллера, доверие операторов, прослеживаемость и производственные риски. Цель заключается в сохранении быстрого локального инференса при обновлении возможностей распознавания только тогда, когда данные показывают, что текущая модель больше не соответствует реальному процессу.
Лучшие практики переобучения моделей начинаются с базовой линии
Программе переобучения нужна исходная точка. До развёртывания зафиксируйте версию модели, источник обучающих данных, определения классов, этапы предварительной обработки, пороги распознавания, целевое оборудование и результаты приёмочных испытаний. Для системы машинного зрения сюда относятся положение камеры, настройки объектива, экспозиция, освещение и разрешение изображения. Для вибрационного или акустического распознавания документируйте тип датчика, место установки, частоту дискретизации, фильтрацию и состояние машины во время сбора данных.
Такая базовая линия позволяет отделить реальные изменения процесса от дрейфа конфигурации. Например, после остановки на обслуживание модель может выглядеть хуже, хотя фактической причиной является смещённая камера, заменённый датчик, изменённый коэффициент усиления или новая временная настройка trigger-сигнала. Переобучение модели для компенсации ошибки монтажа может скрыть настоящую проблему и сделать систему менее стабильной.
Критерии приёмки должны быть связаны с эксплуатационным решением. Одной общей точности почти всегда недостаточно. В приложении обнаружения дефектов приоритетом может быть recall, поскольку пропущенные дефекты дорого обходятся. В задаче остановки машины может быть важнее precision, потому что ложные тревоги прерывают производство. Мониторинг состояния может требовать устойчивого распознавания в широком диапазоне нагрузок, а не максимального показателя на узком тестовом наборе.
Выявляйте дрейф до того, как он станет производственной проблемой
Дрейф модели бывает нескольких видов. Data drift возникает, когда поступающие сигналы отличаются от распределения обучающих данных. Concept drift возникает, когда меняется связь между сигналом и правильной меткой. Performance drift проявляется, когда подтверждённые результаты показывают, что развёрнутая модель стала чаще принимать неправильные решения.
Промышленные системы не всегда могут сразу получить ground truth. Вибрационный классификатор может отметить необычное состояние, но подтверждение появится только после инспекции или обслуживания. Система визуальной инспекции может отбраковать деталь, а последующая проверка качества определит, была ли отбраковка оправданной. Архитектуру мониторинга необходимо проектировать с учётом такой задержки, а не делать вид, что каждую инференс-операцию можно немедленно разметить.
Отслеживайте эксплуатационные показатели, действительно значимые для приложения: частоту классов, распределение уверенности, уровень отбраковки, частоту неизвестных паттернов, отчёты о ложных срабатываниях и соответствие подтверждённым результатам инспекции. Резкий рост классификаций с низкой уверенностью может указывать на новую поверхность материала или загрязнение датчика. Постепенное изменение вибрационных сигнатур может быть связано со старением оборудования, но также может указывать на проблему крепления датчика.
Используйте признаки дрейфа как повод для расследования, а не для автоматического переобучения. Автоматическое включение всех новых наблюдений создаёт обратную связь, при которой ошибочные метки, кратковременный шум и редкие аномальные условия могут постепенно стать «нормой». В производстве неизвестный паттерн часто ценен именно потому, что остаётся неизвестным до проверки специалистом.
Заранее определите триггеры переобучения
До развёртывания задайте количественные и эксплуатационные триггеры. Примерами могут быть устойчивый рост подтверждённой ложной отбраковки, падение recall по дефектам ниже утверждённого предела, новая рабочая рецептура, замена критического датчика или запланированное изменение продукта. Для каждого триггера определите период наблюдения, ответственного специалиста и необходимую доказательную базу.
Пороговые значения должны соответствовать изменчивости процесса. Упаковочная линия с частыми изменениями дизайна будет требовать другой частоты пересмотра модели, чем система мониторинга двигателя, где сигнатуры меняются в течение месяцев. Правильный вопрос заключается не в том, как часто нужно переобучать модель, а в том, каких доказательств достаточно для обоснованного контролируемого обновления.
Формируйте обучающие данные вокруг реального эксплуатационного диапазона
Самая частая ошибка при переобучении — собирать больше данных, не делая их более репрезентативными. Большой набор почти одинаковых изображений или форм сигналов даёт мало новой информации. Обучающий набор должен охватывать условия, которые система должна различать: нормальные вариации, известные дефекты, шум датчиков, изменения скорости и нагрузки, окружающие условия и утверждённые варианты продукции.
Сохраняйте исходные валидированные данные, если только нет документированной причины удалить их. Обучение только на недавних примерах может вызвать catastrophic forgetting, когда новая модель хорошо работает на последних условиях, но теряет способность распознавать ранее допустимые состояния. Сбалансированный набор сохраняет уже проверенные классы и добавляет примеры из изменившейся среды.
Управление метками не менее важно, чем объём данных. Определяйте каждый класс в эксплуатационных терминах и включайте пограничные примеры в процедуру разметки. Например, класс царапин должен иметь измеримое правило инспекции, а не субъективное описание. В мониторинге состояния необходимо отличать подтверждённый дефект подшипника от кратковременного удара, слабого крепления или вибрации, вызванной процессом. Если квалифицированные специалисты не согласны с меткой, нельзя ожидать, что модель изучит стабильную границу класса.
Создайте карантинный набор для сомнительных примеров. Они могут быть полезны для расследований, но не должны автоматически попадать в обучение только потому, что доступны. В приложениях с серьёзными последствиями качество меток обычно влияет на результат сильнее, чем ещё одна неконтролируемая партия полевых данных.
Валидируйте переобученную модель относительно производственного риска
Для валидации необходимо использовать данные, которые модель не видела во время обучения или настройки. Там, где это важно, следует также сохранять разделение по времени, машинам, партиям и объектам. Случайное распределение почти одинаковых последовательных кадров или записей между обучающим и тестовым наборами может дать чрезмерно оптимистичный результат, который исчезнет в реальном производстве.
Сравнивайте модель-кандидат с текущей утверждённой моделью на одном и том же holdout-наборе. Оценивайте precision и recall по классам, характер ошибок, распределение уверенности и задержку обработки. Новая модель не становится автоматически лучше только потому, что её общая оценка выше. Она может улучшить частый класс, одновременно увеличив число пропусков редкого, но критического дефекта.
Целенаправленно используйте challenge-данные. Добавляйте загрязнённую оптику, более низкий контраст, детали под нестандартным углом, изменчивый фоновый шум, другие скорости машины и примеры около границ решения. Цель заключается не в доказательстве идеальности модели. Нужно понять, где управляющая логика должна отбраковывать результат, запрашивать проверку или действовать консервативно.
Для периферийных развёртываний проверяйте реальную целевую архитектуру. Модель, протестированная на рабочей станции разработчика, может вести себя иначе с полевым датчиком, встроенным pipeline предварительной обработки, интерфейсом контроллера или реальными требованиями по времени. Измеряйте сквозную задержку от получения сигнала до распознавания и выходного действия. Проверяйте использование памяти, ограничения по питанию, поведение при запуске и восстановление после потери связи.
Контролируйте развёртывание, а не только файл модели
Каждое утверждённое обновление должно иметь версионируемый релизный пакет. В нём необходимо указать модель, ревизию обучающего набора, конфигурацию предварительной обработки, карту классов, пороги, целевое оборудование, отчёт испытаний, утверждающего специалиста и способ отката. Такая запись позволяет инженерной команде спустя месяцы воспроизвести логику решения, если изменится состояние линии или аудит потребует доказательств.
Если приложение позволяет, разворачивайте обновления поэтапно. Особенно эффективен shadow mode: модель-кандидат получает реальные сигналы, но не управляет процессом. Её результаты можно сравнивать с активной моделью и подтверждёнными исходами. Ограниченное развёртывание на одной машине, одной смене или одной семье продуктов создаёт дополнительную контрольную точку перед масштабным выпуском.
Откат должен быть быстрым и протестированным. Недостаточно просто хранить предыдущую утверждённую модель, если операторы не могут восстановить её без остановки производства или если изменились зависимости конфигурации. Документируйте процедуру, проверяйте её при вводе системы в эксплуатацию и заранее определяйте, кто имеет право инициировать откат.
Решения NeuroTechnologijos позволяют держать распознавание рядом с датчиками и управляющим оборудованием благодаря обучаемым нейронным контроллерам и аппаратным форматам, ориентированным на edge. Такая архитектура снижает зависимость от постоянного облачного подключения, но одновременно повышает важность дисциплины релизов: на каждом локальном устройстве должны быть правильная модель, правильная конфигурация и прослеживаемый статус утверждения.
Рассматривайте переобучение как часть управления изменениями
Обновление модели может совпасть с механическим обслуживанием, сменой поставщика, работами по интеграции программного обеспечения или изменением технологической рецептуры. Координируйте эти изменения. Если одновременно изменится несколько переменных, позже будет сложно определить причину падения производительности. По возможности вводите по одному контролируемому изменению и сохраняйте связанные производственные записи.
Операторы и специалисты по обслуживанию должны понимать, как система распознавания должна вести себя после обновления. Предоставьте понятную процедуру для сообщения о ложных тревогах, пропущенных событиях и неизвестных паттернах. Их обратная связь — не субъективный шум. При наличии процедуры инспекции и проверки она становится источником размеченных эксплуатационных данных.
Наиболее сильные программы переобучения намеренно консервативны. Они фиксируют значимые полевые вариации, сохраняют проверенные знания, тестируют модель на действительно важных механизмах отказа и выпускают обновление только тогда, когда производственная необходимость очевидна. Такая дисциплина превращает переобучение из постоянного исправления проблем в контролируемый способ поддерживать промышленный интеллект в соответствии с машиной, которую он обслуживает.
